第85回ブログ|GitHub Copilot Fusion を初心者向けにやさしく解説 ─ 「どのAIを使うか」をAIが決める時代に、ClaudeやGPTとの違いを考える
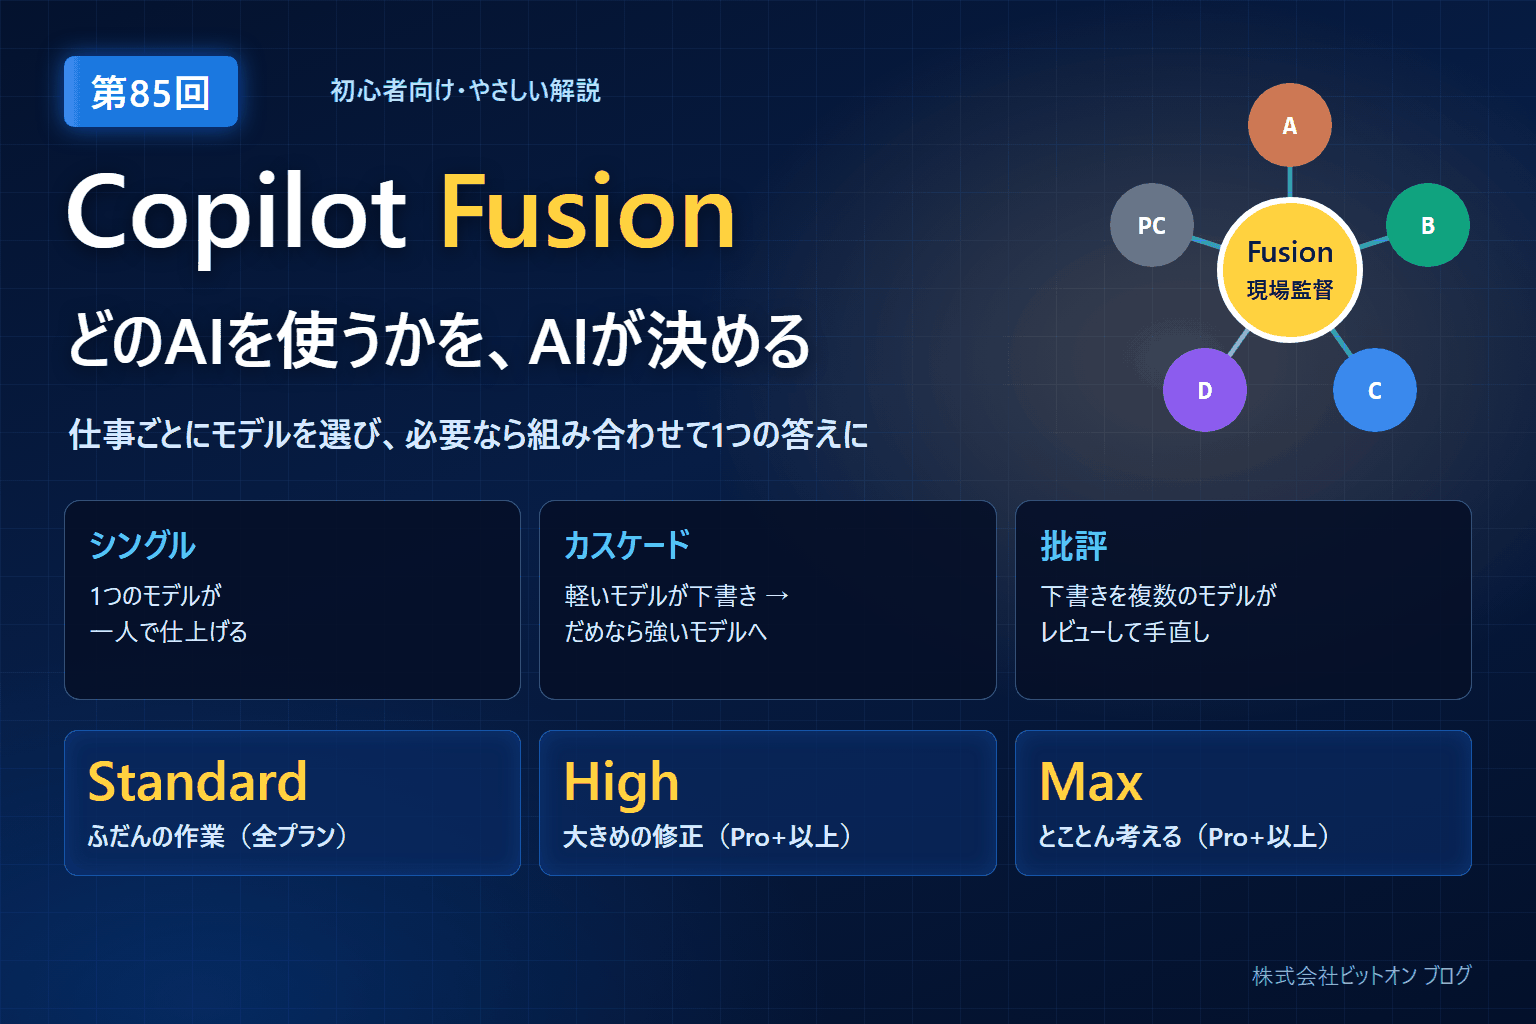
2026年10月28日、プログラミングを手伝ってくれるAI「GitHub Copilot(コパイロット)」に、Copilot Fusion(フュージョン)という機能が正式に加わりました。
これまでのCopilotでは、ClaudeやGPTなど、どのAIモデルに答えてもらうかを利用者が選ぶのが基本でした。Copilot Fusionを選ぶと、その選択をCopilotが仕事ごとに代わりに行い、必要なら複数のモデルを組み合わせて1つの答えを返してくれます。
この記事では、公式ドキュメントと発表記事をもとに、仕組みをできるだけやさしくご紹介します。後半では、「ClaudeやGPTを直接使うのと何が違うのか」「これからの主流になるのか」について、当社の考えをお話しします。
まず前提:Copilotの「モデル選び」とは
GitHub Copilotは、プログラムを書く作業をAIが手伝ってくれるサービスです。Visual Studio Code(VS Code)などのエディタの中で、AIに質問したり、コードの修正を頼んだりできます。
Copilotの特徴の1つは、1つの会社のAIだけでなく、いろいろな会社のAIモデルを使えることです。画面には「モデルピッカー」というモデルの選択欄があり、AnthropicのClaude、OpenAIのGPTなどから、使うモデルを選べます。
選べるのは便利な反面、悩みのもとにもなっていました。
- モデルの数が多く、次々に新しいモデルが出てくるため、どれが何に向いているのかわかりにくい
- 難しい仕事のために高性能(=料金も高め)なモデルに切り替えたまま、簡単な仕事でもそのまま使い続けてしまう
- 「このモデルに書かせて、別のモデルに見直してもらう」といった工夫は、人が手作業でやるしかない
Copilotにはこれまでも、モデルを自動で選ぶ「Auto(自動選択)」がありました。Copilot Fusionは、その考え方をさらに進めたものです。
- AIモデル(LLM)
- 文章やプログラムを読み書きするAIの「頭脳」にあたる部分です。Claude(Anthropic社)、GPT(OpenAI社)、Gemini(Google社)などがあります。同じ会社の中でも、速くて安いもの、じっくり考えて賢いものなど、いくつもの種類があります。
- ルーター
- もとはネットワークで通信の行き先を決める機械のことです。AIの分野では、「この質問はどのモデルに回すか」を決める仕組みをこう呼びます。
- オーケストレーター
- オーケストラの指揮者のように、複数のAIモデルに役割を割り振り、連携させて1つの仕事を仕上げる仕組みです。
Copilot Fusionをひとことで言うと
公式ドキュメントでは、Copilot Fusionは「実行時にモデルを振り分け、連携させる仕組み(ルーター兼オーケストレーター)」と説明されています。
たとえるなら、腕のいい「現場監督」です。
- 簡単な仕事なら、手の空いている職人さんに一人で任せる
- 少し心配な仕事なら、まず若手に任せて、ベテランが出来を確認し、だめならベテランに引き継ぐ
- 大事な仕事なら、一人が仕上げたものを、複数の目でチェックしてから手直しする
利用者は、モデルピッカーで「Copilot Fusion」を選ぶだけです。特定のモデルを選ぶのではなく、「仕事ごとにモデルを選んで連携させる仕組み」を選ぶ、というのがポイントです。作業の途中でモデルを切り替えたり、「この段階にはどのモデルが合うか」を考えたりする必要はありません。
モデルを選ぶときには、仕事の内容だけでなく、各モデルがその時点で混み合っていないか、止まっていないかといった状態も考慮されます。
仕事に合わせて選ばれる3つの働き方
Copilot Fusionは、頼まれた仕事を評価し、「推論」「コードを書く力」「不具合の調査(デバッグ)」「ツールの使いこなし」といった能力の目安をもとに、求められる品質を満たす中で、いちばん効率のよい進め方を選びます。進め方(実行パターン)は次の3種類です。
| 実行パターン | 何をするか | たとえると |
|---|---|---|
| シングル(Single) | 1つのモデルが仕事を最後までこなします | 職人さんが一人で仕上げる |
| カスケード(Cascade) | 効率のよい(軽くて安い)モデルが下書きを作り、判定役がそれを確認します。合格ならそのまま採用し、足りなければより高性能なモデルに引き継ぎます | 若手が下書きし、ベテランが確認。だめならベテランが引き継ぐ |
| 批評(Critique) | 1つのモデルが下書きを作り、複数のモデルがそれぞれ並行してレビューします。意見をまとめたうえで、最初のモデルが手直しします | 書いた原稿を、複数の人が赤ペンでチェックしてから直す |
※日本語版の公式ドキュメントでは、Cascadeが「重ねて表示」と訳されていますが、英語の原文では「段階的に引き継ぐ」という意味合いです。この記事では「カスケード」と表記しています。
進め方は質問(プロンプト)ごとに選ばれます。そのため、同じ会話の中でも、最初の質問はシングル、次の質問は批評、ということが起こります。
大切なのは、必要なときだけモデルを追加で呼び出すことです。簡単な仕事でわざわざレビューを挟むことはないため、待ち時間や料金のムダが出にくくなっています。シングルは1つのモデルに頼むのと同じように動き、カスケードと批評はレビューが入る分だけ時間がかかります。
画面ではどう見えるの?
- 作業中は、いまどの段階で、どのモデルが動いているかを確認できます
- 途中の下書きは手直しされたり捨てられたりすることがあるため、画面に出るのは最終的な回答だけです
- 回答の下にある作業レベル名にマウスを重ねると、実際に使われたモデルの一覧が表示されます
利用者が選ぶのは「作業レベル」だけ
利用者が決めるのは、「どれくらい力を入れて取り組んでほしいか」という作業レベルです。品質・料金・速さのどれを優先するかを、ざっくり指定するイメージです。
| 作業レベル | 優先すること | 向いている仕事 |
|---|---|---|
| Fusion Standard | 料金・品質・速さのバランス | ふだんの作業。仕事ごとに1つのモデルが選ばれます |
| Fusion High | ほどよく料金を抑えつつ、複数モデルの連携も使う | 複雑な不具合の修正や、複数のファイルにまたがる変更など、範囲がはっきりした大きめのコーディング作業 |
| Fusion Max | 最先端の性能(料金の効率も考慮はする) | とことん深く考え、徹底的に分析してほしい仕事 |
| Fusion Fast | 速さが必要な場面専用 | 利用者は選べません。VS Codeのインラインチャット(コードの中で直接AIに頼む機能)でのみ使われます |
使える作業レベルは、Copilotのプランによって異なります。
| 作業レベル | Free | Student | Pro | Pro+ | Max | Business | Enterprise |
|---|---|---|---|---|---|---|---|
| Fusion Standard | ○ | ○ | ○ | ○ | ○ | ○ | ○ |
| Fusion High | - | - | - | ○ | ○ | ○ | ○ |
| Fusion Max | - | - | - | ○ | ○ | ○ | ○ |
| Fusion Fast | ○ | ○ | ○ | ○ | ○ | ○ | ○ |
無料プランを含むすべてのプランで、Fusion Standardを使えます。HighとMaxは、Pro+以上の個人プランと、法人向けのBusiness・Enterpriseで使えます。
使える場所と始め方
Copilot Fusionは、次の4つの環境で正式に使えます。発表では、ほかの環境にも近く対応するとされています。
- Visual Studio Code
- GitHub Copilot CLI(コマンドラインで使うCopilot)
- GitHub Copilot app
- JetBrains製のIDE(IntelliJ IDEAなど)
始め方はかんたんです。
- エディタやCopilotのアプリを最新版に更新します
- モデルピッカーを開き、「Copilot Fusion」を選びます
- 作業レベル(Standard・High・Max)を選びます
上の4つの環境では、Copilot Fusionがこれまでの「Auto」に置き換わる形で、順番に提供が広がっています。モデルピッカーに「Auto」ではなく「Copilot Fusion」が表示されていれば、使える状態です。なお、Visual Studio、Xcode、Eclipse、GitHubのWebサイト上のCopilot Chatなどでは、引き続き従来のAutoが使われます(2026年11月3日時点の公式ドキュメントによる)。
会社でCopilotを導入している場合は、管理者がCopilot Fusionで使えるモデルを決めたり、Copilot Fusionを標準の設定にしたりできます。管理者が使用を止めているモデルは、Copilot Fusionも使いません。
料金の考え方
- Copilot Fusionそのものに追加料金はかかりません。実際に使われた各モデルの、通常の料金がかかります
- Fusion HighとFusion Maxは、1つの仕事で複数のモデルを使うことがあるため、Standardより多くのAI credits(Copilotの利用枠)を消費する場合があります
- 2026年11月30日まで、有料プランの利用者は、Copilot Fusionを使ったときのモデル料金が30%引きになります(期間限定)
また、会話の中心はできるだけ同じモデルのまま続けるように作られています。AIサービスには、直前までの会話をため置いて再利用すると安く・速くなる「キャッシュ」という仕組みがあり、むやみにモデルを切り替えるとその恩恵を失ってしまうためです。レビュー役などの補助的なモデルには、必要な情報だけが渡されます。
※ちなみに、従来のAutoでも有料プランでは10%の割引があります。Copilot Fusionの30%引きは期間限定のため、12月以降の扱いは公式の発表をご確認ください。
手元のパソコンのAIも使えるように(プレビュー)
同じ日に、手元のパソコンで動くAIモデル(ローカルモデル)もCopilot Fusionの選択肢に入れられるようになりました。こちらはまだ試験的な機能(パブリックプレビュー)で、今後変わる可能性があります。
- 対象モデルはMAI Code 1.1 FlashとQwen3.8 Flash Nextの2つです
- 条件を満たすWindowsパソコンでは、Copilot CLI、Copilot app、VS CodeからMAI Code 1.1 Flashをダウンロードして使えます
- Copilot CLIでは、Ollamaなどで自分で用意したQwen3.8 Flash Nextも使え、Windows・macOS・Linuxに対応しています
- ローカルモデルが使われるのは、Fusion Standardのときだけです
- 使うには、実験的機能を有効にする必要があります(Copilot CLIなら
--experimentalを付けて起動するか、/experimental onを実行します)
簡単な仕事は手元のパソコンで、難しい仕事はクラウドの高性能なモデルで、という使い分けを自動でしてくれるわけです。ただし、発表では次の点も明記されています。
- オフラインで使えるようになるわけではありません。どのモデルに回すかの判断は、引き続きクラウド側で行われます
- ローカルモデルは、Copilotが提供するクラウドのモデルとは安全対策の内容が異なる場合があります
ローカルLLMについては、第81回「日本語に強いローカルLLM徹底比較」でもくわしくご紹介しています。
知っておきたい注意点
- 捨てられた下書きの変更は、元に戻りません: 下書きの段階でファイルを書き換えていた場合、その下書きが採用されなくても、変更は自動では取り消されません。コミットする前に、必ず変更内容を確認しましょう
- どのモデルが使われるかは、あらかじめ決められません: 同じ依頼でも、そのときの状況で違うモデルが選ばれることがあります。使えるモデルの顔ぶれや進め方も、新しいモデルの登場などで変わっていきます
- 扱える文章量の上限は控えめに表示されます: Copilot Fusionには独自の上限(コンテキストウィンドウ)がなく、使うモデルの中でいちばん小さい上限を目安として表示します
- サブエージェントとは別の仕組みです: Copilot Fusionが、仕事を分担する「サブエージェント」を自分から起動することはありません
- 使えるモデルがないと表示されません: プランや会社のポリシーで、Copilot Fusionが使うモデルがすべて使えない場合、モデルピッカーに出てきません
誕生の経緯と、発表されている成績
Copilot Fusionのもとになったのは、2026年9月4日に研究段階の試験版として公開された「Project HydraFusion(ハイドラフュージョン)」です。GitHubはその発表で、HydraFusionの目標を「最良のモデルを選ぶことから、仕事ごとに最良の解き方を組み立てることへ」と表現していました。
正式版のCopilot Fusionは、HydraFusionの「複数モデルの連携」と、従来のAutoの「モデル選び」の両方の長所を組み合わせたものだと説明されています。試験版でAutoやHydraFusionを選んでいた人は、対応する作業レベルに自動で切り替わります。
GitHubが発表している数値
試験版の段階では、3種類のコーディング用の評価で、AnthropicのClaude Opus 5を単独で使った場合と比べて次の結果だったと発表されています(いずれもGitHub社内での事前評価です)。
| 評価(ベンチマーク) | 料金(Opus 5比) | 正答率(Opus 5比) |
|---|---|---|
| TerminalBench 2.1 | 67%安い | 4.9ポイント高い |
| DeepSWE | 36%安い | 1.5ポイント低い |
| CheckpointBench(GitHub独自) | 65%安い | 0.1ポイント低い |
正式版の発表では、外部の評価指標「Artificial Analysis Coding Agent Index」で、Fusion Maxが60点となり、Claude Opus 5.5 Max を使ったClaude Codeに2ポイント差まで迫ったとしています。しかも、1つの仕事あたりの平均API料金は約半分、使ったトークン(AIが処理する文字の単位)も約半分、かかった時間は約40%短かったとのことです。
通信大手AT&Tのエンジニアも、「開発者は難しい仕事のために強力なモデルを選び、日常の作業に戻すのを忘れがちだった。Copilot Fusionはその手間をなくしてくれた」という趣旨のコメントを寄せています。
※数値はいずれもGitHubの発表によるもので、当社では計測していません。ベンチマークの結果が、そのまま皆さんの業務にあてはまるとは限りません。
考察1:ClaudeやGPTを直接使うのと何が違う?
ここからは、公開情報をもとにした当社の考察です。
まず整理しておきたいのは、ClaudeやGPTは「AIモデル(エンジン)」であり、Copilot Fusionは「エンジンの使い方を決める仕組み」だということです。Copilot Fusionの裏側でも、ClaudeやGPTなどのモデルが働いています。つまり、両者は対立するものではなく、層が違うものです。
比べるべきなのは、「Claude Code(Anthropic)やCodex(OpenAI)のように、1つの会社のモデルを、その会社の道具で使う」場合と、「Copilot Fusionに、複数の会社のモデルの使い分けを任せる」場合です。
Copilot Fusionならではの付加価値
- 会社の垣根をこえた「別の目」でのチェック
HydraFusionの発表では、批評のパターンについて「別の系統のモデルがレビューする」と説明されています。人間でも、自分で書いた文章の誤りは自分では気づきにくいものです。同じ会社のモデル同士より、学習のしかたが違うモデルに見てもらうほうが、見落としを拾える可能性が高まります。これは、1社のモデルしか持たない道具には、構造的にまねしにくい強みです。 - 「ちょうどいい」モデルを自動で選んでくれる
簡単な仕事は安いモデル、難しい仕事は高いモデルと、仕事ごとに切り替えてくれます。AT&Tのコメントにあるように、「高いモデルを選んだまま戻し忘れる」というムダがなくなります。利用者が増えるほど、この差は会社全体の費用に効いてきます。 - モデル選びの知識がいらない
AIモデルは、数か月ごとに新しいものが登場します。そのたびに比較記事を読んで乗り換えを検討するのは大変です。Copilot Fusionでは、新しいモデルの評価と組み込みをGitHubが行うため、利用者は何もしなくても新しいモデルの恩恵を受けられます。 - 1社のトラブルに強い
モデルを選ぶときに、各モデルが混んでいないか、止まっていないかも考慮されます。1つの会社のサービスが不調でも、ほかの会社のモデルに回れる余地があります。 - 会社として管理しやすい
使ってよいモデルを管理者が決め、その範囲の中で自動的に使い分けてくれます。「どのAIを使わせるか」というルールと、「現場が楽に使えること」を両立しやすくなります。
逆に、ClaudeやGPTを直接使う良さ
- 最高の性能を狙うなら、まだ直接指定に分がある: 先ほどの評価でも、最高点はClaude Code(Claude Opus 5.5 Max)の62点でした。Copilot Fusionは「ほぼ同じ性能を、半分の料金で」という立ち位置です
- 動きが予測しやすい: 毎回同じモデルが答えるので、クセや得意・不得意をつかみやすく、結果の再現もしやすくなります
- 各社の新機能をいち早く、深く使える: モデルを作っている会社の道具は、そのモデルの能力を引き出すように細かく作り込まれています
なお、AnthropicやOpenAIも、自社のモデルの中では「仕事に応じて軽いモデルと重いモデルを使い分ける」仕組みを取り入れています。モデルを自動で使い分けるという考え方そのものは、業界全体の流れです。そのうえでCopilot Fusionの独自性は、「複数の会社のモデルを、1つの仕事の中で組み合わせられる」点にあると当社は考えています。
考察2:これからの主流になるのか
当社の見立て:「ふだん使いの標準」としては主流になっていく可能性が高い。ただし、モデルを指名して使う方法がなくなるわけではない
主流になると考える理由
- GitHub自身が「標準」にしようとしている: Copilot Fusionは、主要な4つの環境で従来のAutoに置き換わる形で提供されています。会社の管理者が標準の設定にすることもできます。多くの人は、最初に設定されたものをそのまま使うため、自然と利用が広がると考えられます
- モデルは増え続け、人が選びきれなくなっている: 選択肢が多すぎると、選ぶこと自体が負担になります。「目的だけ伝えれば、道具は任せる」という流れは、ほかの分野でもよく見られます
- 料金の圧力: AIの利用量が増えるほど、会社にとって費用は無視できなくなります。「同じくらいの品質なら安いほうがいい」という判断を自動でしてくれる仕組みは、経営側にも歓迎されやすいはずです
- 手元のAIとクラウドのAIの使い分けにつながる: ローカルモデルの自動振り分けが始まったことで、「簡単な仕事は手元で、難しい仕事はクラウドで」という形が現実的になってきました。どこで処理するかまで自動で決めるには、こうした振り分けの仕組みが欠かせません
それでも残る課題
- 「なぜこのモデルが選ばれたのか」が見えにくい: 使われたモデルの一覧は確認できますが、選ばれた理由まではわかりません。品質の説明責任が求められる業務では、モデルを固定したいという声は残るでしょう
- 料金の見通しが立てにくい: HighやMaxでは、仕事によって使うモデルの数が変わるため、1回あたりの料金が読みにくくなります
- 待ち時間: カスケードや批評では、レビューの分だけ時間がかかります。すぐに答えがほしい場面では、もどかしく感じるかもしれません
- 成績はまだ発表元の数値が中心: 正式提供が始まったばかりで、利用者側からの実際の評価はこれから出てくる段階です
自動車にたとえると、オートマチック車が主流になっても、マニュアル車を好む人や、マニュアルでなければならない場面が残っているのに似ています。ふだんはCopilot Fusionに任せ、ここぞという場面ではモデルを指名する。当面は、そうした「任せる」と「指名する」の使い分けが定着していくと当社は考えています。
当社のおすすめの使い分け
- ふだんの質問や小さな修正: Fusion Standardに任せます。料金を気にせず、気軽に使えます
- 複数のファイルにまたがる修正や、手ごわい不具合: Fusion Highを試してみる価値があります。範囲をはっきり伝えるのがコツです
- 設計の見直しなど、とことん考えてほしい仕事: Fusion Maxか、信頼しているモデルを直接指名します
- どのモデルを使ったかの記録が必要な仕事: モデルを固定して使うほうが安心です
- どの場合も: AIが変更した内容は、コミットする前に人が確認します。特にCopilot Fusionでは、採用されなかった下書きの変更が残ることがあるため大切です
有料プランの方は、30%引きの期間(2026年11月30日まで)に、いつもの作業をCopilot Fusionで試してみるとよいでしょう。会社で導入している場合は、管理者の方がCopilot Fusionで使えるモデルの設定を一度確認しておくと安心です。
まとめ
- Copilot Fusionは、仕事ごとにAIモデルを自動で選び、必要なら複数のモデルを組み合わせて1つの答えを返す仕組みです。2026年10月28日に正式提供が始まりました
- 進め方は「シングル」「カスケード」「批評」の3種類。利用者は作業レベル(Standard・High・Max)を選ぶだけです
- すべてのプランでStandardが使えます。HighとMaxはPro+以上と法人プランが対象です
- Copilot Fusion自体の追加料金はなく、使ったモデルの料金がかかります。11月30日までは30%引きです
- ClaudeやGPTは「エンジン」、Copilot Fusionは「エンジンの使い方を決める仕組み」。会社の垣根をこえて組み合わせ、別の目でチェックできるのが独自の付加価値です
- ふだん使いの標準としては主流になっていく可能性が高い一方、最高性能や再現性が必要な場面では、モデルを指名する使い方も残ると考えます
AIの世界では、「どのモデルがいちばん賢いか」という競争が続いてきました。Copilot Fusionは、そこに「モデルをどう組み合わせるか」という新しい競争の軸を持ち込んだと言えそうです。一人の天才に頼るより、得意分野の違うメンバーでチームを組むほうがよい仕事ができる。人間の職場でおなじみの考え方が、AIにも当てはまり始めているのは興味深いことです。
GitHub Copilotをはじめとする生成AIの業務への取り入れ方や、開発体制の見直しなどでお困りのことがあれば、どうぞお気軽にご相談ください。
参考資料(2026年11月3日時点で確認)
- GitHub Copilot Fusion について(GitHub公式ドキュメント)
- Route and orchestrate models with GitHub Copilot Fusion(GitHub Changelog、2026年10月28日)
- GitHub Copilot Fusion now supports selection of local models(GitHub Changelog、2026年10月28日)
- Project HydraFusion: Frontier quality via multi-model orchestration(GitHub Blog、2026年9月4日)
- GitHub Copilot の自動モデル選択について(GitHub公式ドキュメント)
- 第81回ブログ|【2026年10月版】日本語に強いローカルLLM徹底比較
本記事は2026年11月3日時点の公開情報に基づきます。ベンチマークや料金の数値はGitHubの発表によるもので、当社で計測したものではありません。「考察」の部分は当社の見解です。提供範囲・料金・割引は変更される場合があるため、導入前には公式情報をご確認ください。