第81回ブログ|【2026年10月版】日本語に強いローカルLLM徹底比較 ─ Qwen3.8・LLM-jp-4.1・Nemotron 3.5の登場で、VRAM帯別の最適解はどう変わったか
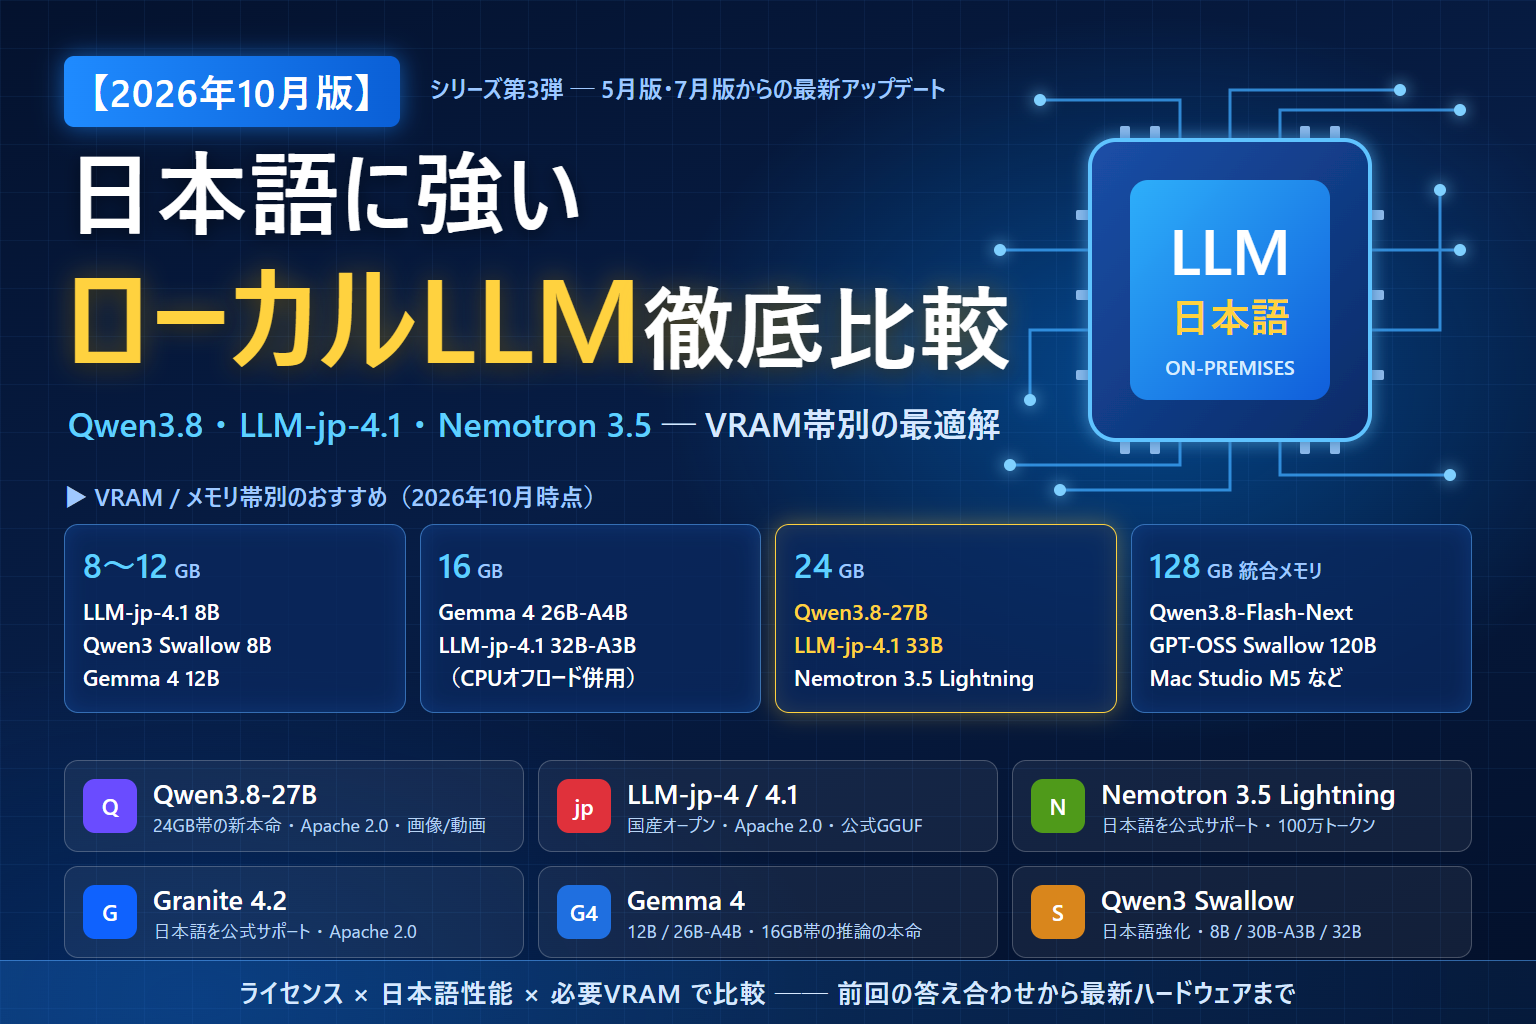
5月の第71回で「日本語に強いローカルLLM」を比較し、7月の第74回で続報をお届けしました。それから2か月で、手元のGPUで動くクラスに有力な新しいモデルが続々と登場しています。Qwen3.8-27B、国産のLLM-jp-4 / 4.1、日本語を公式にサポートするNemotron 3.5 LightningとGranite 4.2などです。ハードウェアでも、128GB以上の統合メモリを積んだマシンが一気に増えました。今回は前回の答え合わせから始めて、2026年10月時点で「どのVRAM帯で、どのモデルを選べばよいか」を、あらためて比較表にまとめてみます。
環境構築の手順(Docker + Ollama + Open WebUI など)は第71回から大きく変わっていませんので、そちらをご参照ください。本記事では、モデル選びとハードウェア選びの判断材料に絞ってお話しします。
前回(7月版)の答え合わせ
まずは、第74回でお伝えした見通しが当たっていたかを確認しておきます。外れていた点や不正確だった点は、ここで訂正させてください。
| 第74回の記述 | 2026年10月時点の事実 | 判定 |
|---|---|---|
| Kimi K3の重みは7月27日までに公開予定 | Hugging Faceでmoonshotai/Kimi-K3として公開済み。ただしアクティブパラメータは約50Bではなく約104B(896エキスパート中16を起動)。ライセンスも「Modified MIT」ではなく、独自のKimi K3 Licenseでした | 公開は的中。規模とライセンスは訂正 |
| Qwen3.7はAPI専用で、オープン版は一世代前 | Qwen3.7世代はオープンウェイトが出ないまま、8月にQwen3.8世代でオープン版(27Bほか)が公開されました | 概ね的中 |
| Gemma 4 26B-A4Bが16GB帯の推論の本命 | 総25.2B / アクティブ3.8B、256Kコンテキスト。評価は引き続き高いままです | 的中 |
| DeepSeek V4はOllama / llama.cppの安定版で未対応 | llama.cppは6月29日の時点で本体に対応が取り込まれていました(PR #24162)。Ollamaでは8月下旬時点でも、ローカル実行用のタグは確認できていません | llama.cppの部分は誤りでした。訂正します |
| Ollamaの深刻な脆弱性 CVE-2026-7482 | GGUF読み込み時のメモリ外読み出し(通称 Bleeding Llama、CVSS 3.1で9.1)。5月4日公表、v0.17.1で修正済み。v0.32以降をお使いであれば影響はありません | 補足です。「新しい脆弱性」ではなく、すでに修正済みの問題でした |
とはいえ、CVE-2026-7482から得られる教訓は今も変わりません。認証のないOllama(ポート11434)を、インターネットから届く場所に公開しないようにしてください。セキュリティ研究者の報告によると、ポートを公開したままのOllamaサーバーは世界に約30万台あるそうです。
この2か月で何が変わったか ─ 3つのポイント
- 16〜32GB帯に新しい候補が増えました: Qwen3.8-27B(Apache 2.0)、Nemotron 3.5 Lightning 30B-A3B(日本語を公式サポート)、Granite 4.2(日本語を公式サポート、Apache 2.0)。どれも公式、またはそれに近いGGUFが用意されていて、Ollamaですぐに試せます
- 国産オープンモデルでは、LLM-jpが大きく前進しました: 国立情報学研究所(NII)のLLM-jpが、8月にLLM-jp-4 33B、9月28日にLLM-jp-4.1(8B / 32B-A3B / 33B)を公開しています。いずれもApache 2.0で、公式のGGUFもあります。一方、Swallowやほかの国産勢からは、この期間に汎用の新モデルは出ていません
- 「128GB以上の統合メモリ機」が現実的な選択肢になりました: 9月にMac Studio(M5 Max / M5 Ultra)が発売され、AMDも最大192GBのRyzen AI Max 400を発表しています。NVIDIAのRTX Sparkも10月に登場する予定です。ただその一方で、GPUとメモリの価格高騰は続いています
日本語性能の現在地 ─ ランキングから見えること
日本語LLMの総合評価としてよく参照されるNejumi Leaderboard 4は、8月に更新されました。Qualitegさんが9月1日に公開した分析記事をもとに、主なスコアを整理してみます(当社ではリーダーボードの元データとの突き合わせまではしていませんので、あくまで目安としてご覧ください)。
| 区分 | モデル | 総合スコア | 備考 |
|---|---|---|---|
| クローズド(首位) | Claude Opus 5 | 0.872 | API専用 |
| オープンウェイト最上位 | Qwen3.8-2.4T-A95B | 0.860 | 総合3位。ただし2.4兆パラメータのため、ローカルでの実行は現実的ではありません |
| オープンウェイト | Kimi K3 | 0.843 | サーバー級(後述) |
| オープンウェイト | Qwen3.8-Flash-Next / GLM-5.3 | 0.829 | 前者は128GB機で現実的な範囲 |
| 国産・日本語強化 | GPT-OSS-Swallow-120B-RL | 0.691 | 国産・日本語強化モデルの中で最上位 |
| 国産 | llm-jp-4-33b-thinking | 0.676 | 24GB帯で動く国産モデル |
| 国産・日本語強化 | Qwen3-Swallow-8B-RL | 0.655 | 8B級 |
ここから読み取れることは、大きく2つあります。
- 総合点では、中国系の大型オープンモデルが国産モデルを大きく上回っています。日本語の総合力だけで見れば、QwenやKimiの大型モデルが強いのが現状です
- ただし、日本固有の知識では国産・日本語強化モデルに分があります。日本に関する知識を問うベンチマークJamC-QAでは、日本語で大規模に事前学習したモデルほど高いスコアを出す傾向があります。行政・法務・社内規程のように「日本の制度や言い回し」が大切な業務では、総合スコアだけで選ばないほうが安心です
国産モデルには、もう1つ強みがあります。ライセンスがわかりやすく、学習データの情報も公開されていることです。LLM-jpは、事後学習(SFT・DPO)のデータまで公開しています。社内での説明責任や監査を重視する組織にとっては、性能差を補って余りある魅力になるかもしれません。
徹底比較: 手元・自社サーバーで動く主要モデル(2026年10月)
個人のPCから部門のサーバーまでで、現実的に動かせるモデルを一覧にしました。VRAMの目安は、4bit量子化(Q4_K_M相当)で重みが載るかどうかの概算です。コンテキストを長く取ると、KVキャッシュの分だけ必要な量が増える点にご注意ください。
| モデル | 公開 | 構成(総 / アクティブ) | コンテキスト | ライセンス | 日本語 | VRAM目安(Q4) |
|---|---|---|---|---|---|---|
| LLM-jp-4.1 8B thinking | 2026/9/28 | Dense 約8.6B | 64K | Apache 2.0 | ◎ 国産・日本語特化 | 8GB |
| Qwen3 Swallow 8B | 2026/2 | Dense 8B | ─ | Apache 2.0 | ◎ 日本語強化 | 8GB |
| Granite 4.2 8B | 2026/8/25 | Dense 8B | 128K(最大512K) | Apache 2.0 | ○ 公式に日本語サポート | 8GB |
| Gemma 4 12B | 2026/6/3 | Dense 12B | ─ | Apache 2.0 | ○ 140以上の言語 | 12GB |
| Gemma 4 26B-A4B | ─ | MoE 25.2B / 3.8B | 256K | Apache 2.0 | ○ | 16GB |
| LLM-jp-4.1 32B-A3B thinking | 2026/9/28 | MoE 32B / 3B | 64K | Apache 2.0 | ◎ 国産・日本語特化 | 16GB+CPUオフロード / 24GB |
| Qwen3 Swallow 30B-A3B | 2026/2 | MoE 30B / 3B | ─ | Apache 2.0 | ◎ 日本語強化 | 16GB+CPUオフロード / 24GB |
| Nemotron 3.5 Lightning 30B-A3B | 2026/8/11 | Mamba-2+MoEのハイブリッド 30B / 3B | 100万 | OpenMDW-1.1 | ○ 公式に日本語サポート | 16GB+CPUオフロード / 24GB |
| Qwen3.8-27B | 2026/8/14 | Dense 27B | 262K(拡張で約100万) | Apache 2.0 | ○ 公式の明記はありませんが、Qwen系は日本語での実績があります | 24GB(Q4で約17GB) |
| Granite 4.2 30B | 2026/8/25 | Dense 30B | 128K(最大512K) | Apache 2.0 | ○ 公式に日本語サポート | 24GB |
| LLM-jp-4 33B / 4.1 33B thinking | 2026/8/18・9/28 | Dense 約33B | 64K | Apache 2.0 | ◎ 国産・日本語特化 | 24GB |
| Qwen3 Swallow 32B | 2026/2 | Dense 32B | ─ | Apache 2.0 | ◎ 日本語強化 | 24GB |
| GPT-OSS Swallow 120B | 2026/2 | MoE 120B | ─ | Apache 2.0 | ◎ 日本語強化 | 80GB級 / 128GB統合メモリ |
| Qwen3.8-Flash-Next | 2026/8 | MoE 本体125B / 6B(別途埋め込み等あり) | 262K(最大100万) | Qwen Community 1.0 | ○ | 128GB統合メモリ(推定) |
※「日本語」欄の◎は、日本語に特化、または日本語を強化したモデルです。○は、モデルカードに日本語の明記があるか、日本語での実績がある系統のモデルです。VRAMの目安は当社の概算で、実測値ではありません。導入の前には、必ずご自身の環境で確認してください。なお、Qwen3 Swallow / GPT-OSS Swallowは、2月公開のv0.2 / RL v0.1が最新です(6月に医療特化版が追加されています)。
注目モデル(1): Qwen3.8-27B ─ 24GB帯の新しい基準
- 8月14日に公開されたDenseモデルです。Gated DeltaNetを組み合わせたハイブリッド構成で、262Kトークン(YaRNで約100万まで拡張可能)のコンテキストを扱えます
- テキストに加えて、画像や動画も入力できるマルチモーダル対応です。ライセンスはApache 2.0です
- Q4_K_Mで約17GBなので、24GBのGPUなら、コンテキストに余裕を残したまま載せられます
- 注意点: 3.8世代には、9Bや35B-A3Bといった中間のサイズがありません。16GB帯でQwenを使いたい場合は、引き続き4月公開のQwen3.6-35B-A3Bなどが候補になります
注目モデル(2): LLM-jp-4 / 4.1 ─ 国産オープンモデルの本命
- LLM-jp-4 33B(8月18日): 約11.7兆トークンで学習したDense 33Bです。思考型(thinking)版では、推論の深さを low / medium / high で切り替えられます。モデルカードでは日本語MT-Bench 8.00が報告されています
- LLM-jp-4.1(9月28日): 8B / 32B-A3B(MoE)/ 33Bの3サイズです。理数系の能力が強化され、ツール呼び出し(Function Calling)にも新たに対応しました。回答も以前より簡潔になっています
- どちらもApache 2.0で、商用利用が可能です。公式のGGUFがあり、llama.cpp / Ollama / LM Studioで動かせます
- 画像を扱えるLLM-jp-4-VL 9Bも9月に公開されました。ただ、画像の理解力ではQwen3.5-9Bに大きく及ばないことを、公式ブログ自身が率直に認めています
- 注意点: コンテキストは64Kで、ほかの新モデル(256K〜100万)より短めです。長い文書をまとめて読ませる用途には、あまり向いていません
注目モデル(3): Nemotron 3.5 Lightning / Granite 4.2 ─ 「日本語の公式サポート」を明記した海外勢
- Nemotron 3.5 Lightning 30B-A3B(NVIDIA、8月11日): Mamba-2とMoE、Attentionを組み合わせた構成です。100万トークンのコンテキストを扱え、モデルカードには日本語が対応言語として明記されています。
ollama run nemotron-3.5-lightningですぐに動き、公式のGGUFもあります。RTX 5090やDGX Spark向けのNVFP4版も用意されています - Granite 4.2(IBM、8月25日): 3B / 8B / 30BのDenseモデルです。Apache 2.0で、日本語がテスト済みの言語として明記されています。思考モードの切り替えにも対応しています。企業での説明責任を重視したシリーズなので、ライセンスまわりも確認しやすいのが特長です
- ライセンスの注意: NemotronのOpenMDW-1.1は、Apache 2.0とは条項が異なります。商用でお使いになる前に、法務担当の方に確認していただくことをおすすめします
参考: サーバー級の超巨大MoE(7月以降の動き)
| モデル | 構成 | ライセンス | ローカル実行の現実性 |
|---|---|---|---|
| Kimi K3 | 2.8T / 約104B、100万コンテキスト | Kimi K3 License(独自) | llama.cppは8月15日にテキスト対応が取り込まれました。ただし1bit量子化でも約600GBのメモリが必要です |
| GLM-5.3 / GLM-5.3-Flash | 753B / Flashは320B・アクティブ約18B | GLM-5.3 License / FlashはMIT | FlashはFP8で約328GB。128GB機では、かなり強い量子化が必要です |
| DeepSeek V4.1-Flash | 本体552B、100万コンテキスト | MIT | FP8で約510GB。vLLM 0.30が対応しています |
| Qwen3.8-2.4T-A95B | 2.4T / 95B | 独自(Qwen3.8-Max License) | 大規模なGPUクラスタが前提です |
第74回でもお伝えしたとおり、このクラスは「手元で動かすローカルLLM」というより、「自社で占有できる最先端モデル」と考えるのがよさそうです。中国企業製のモデルを業務で使う際の注意点(API利用とローカル実行の区別、独自ライセンスの確認)も、第74回の内容がそのまま当てはまります。
ハードウェアの現在地 ─ 統合メモリ機の台頭と価格高騰
| カテゴリ | 代表製品 | メモリ | 動向(2026年9月時点) |
|---|---|---|---|
| コンシューマGPU | GeForce RTX 5090 | 32GB | 国内では品薄と価格高騰が続いています。7月には約79万円の製品が即完売したと報じられました。うわさのRTX 50 Superは、GDDR7不足による延期・中止の報道が入り乱れていて、公式発表はまだありません |
| ワークステーションGPU | Intel Arc Pro B70 | 32GB | 3月発売、米国価格949ドル(8月の実売は1,300ドル前後)。32GB帯では手頃な選択肢です |
| 統合メモリ(Apple) | Mac Studio M5 Max / M5 Ultra | 最大128GB / 最大512GB | 9月22日発売。M5 Ultraのメモリ帯域は1.2TB/sです。512GB構成の出荷は10月下旬以降になります |
| 統合メモリ(AMD) | Ryzen AI Max+ 395 / Ryzen AI Max 400 | 128GB / 最大192GB | 395搭載の128GBミニPCは2,400〜3,700ドル前後。192GB版の400シリーズ(Gorgon Halo)は、9月のIFAで搭載機が披露されました |
| 統合メモリ(NVIDIA) | DGX Spark / RTX Spark | 128GB | DGX Sparkは2月に3,999ドルから4,699ドルへ値上げされました。Windows機のRTX Sparkは10月に登場予定です |
| 据え置きAIワークステーション | DGX Station(GB300) | 大容量 | 8月末からOEM機の出荷が始まりました。価格は10万ドル級です |
ここで押さえておきたいのがメモリの価格です。秋葉原の店頭調査(9月24日)では、DDR5-5600の32GB×2枚組が約9万8千円と、2025年春の底値の数倍まで上がっています。第77回でご紹介した「MoEの一部をCPU側のメインメモリへオフロードする」構成はコスト面で有利でしたが、メモリを買い足す負担は半年前よりかなり重くなりました。
そのため、これから機材を購入される場合の考え方も、次のように変わってきています。
- 24〜32GBのGPUを1枚: 30B級までのモデルを高速に動かしたい場合です。27B〜33BのDenseモデルを速く動かすなら、今もこれがいちばんの選択肢です
- 128GBの統合メモリ機: 100B級のMoE(Qwen3.8-Flash-Next、GPT-OSS Swallow 120B)を1台で動かしたい場合です。生成の速さではGPUに及びませんが、「そもそもメモリに載るか」という壁を越えられます
- 今あるPCにメモリを足してオフロード: メモリが高い今は、費用対効果を事前に見積もってから判断するのがおすすめです
ランタイムの更新: Ollama / llama.cpp / vLLM / LM Studio
Ollama(v0.33 → v0.35)
- v0.33系(8月): Claude Desktopのゲートウェイとして動く機能が加わりました。Mac向けのMLXエンジンも、Qwen3.8-Flash-Nextに対応しています
- v0.34系(9月): Mac上でGemma 4の画像・音声入力に対応しました。MLX形式のモデル登録(
ollama create)が正式な機能になり、思考型モデルでの構造化出力も改善されています - v0.35.0(9月28日): 選択・確率・スコアを返す「decision models」用の、新しいエンドポイントが追加されました
- 全体の流れとしては、Mac(Apple Silicon)ではMLXエンジンへの移行が進んでいます。Mac Studio M5との組み合わせは、今後さらに有力になりそうです
- 8〜9月に新しいCVEの公表は見当たりません。それでも、ポート11434を外部に公開しないという原則(
127.0.0.1へのバインド、またはリバースプロキシ+認証)は、ぜひ守るようにしてください
llama.cpp
- 8月15日に、Kimi K3のテキスト対応が取り込まれました(PR #26185)。エキスパート数の上限も1024に引き上げられています
- Qwen3.8-Flash-NextのMTP(複数トークン予測)による高速化や、AMDの内蔵GPU(RDNA3)向けのVulkan最適化も進みました
vLLM(v0.28 → v0.30)
- v0.29.0(9月9日)から、「Model Runner V2」がすべてのモデルで標準になりました。V1はv0.32で削除される予定ですので、本番で運用されている場合は早めの検証をおすすめします。なお、bitsandbytesは外部プラグインに移っています
- v0.30.0(9月22日)ではDeepSeek V4.1-Flashに対応し、エンジンの起動時間も28.9秒から8.2秒に短縮されました
- 使い分けは前回と同じで、1人〜数人で使うならOllama、部門や全社での同時アクセスならvLLMが目安です
LM Studio(0.4.21 → 0.4.25)
- 0.4.21で、社内ネットワーク向けのローカルサーバーにAPIキー認証が付きました。検証用のマシンを部署内で共有するときに便利です
- 投機的デコード(ドラフトモデルによる高速化)の対応形式が増え、Apple Silicon(M3以降)向けの新しいエンジンも追加されました
VRAM帯別・2026年10月版のおすすめ
ここまでの内容を踏まえて、第74回のおすすめを更新します。「日本の知識が問われる業務」と「論理・コード・長文処理が中心の業務」とで、モデルの系統を分けるという前回の考え方は、そのまま引き継ぎます。
| VRAM / メモリ帯 | 前回(7月)の推薦 | 今回(10月)の推薦 |
|---|---|---|
| 8〜12GB | Qwen3-8B系、Qwen3 Swallow 8B、Gemma 4 E2B | 日本語業務: LLM-jp-4.1 8B または Qwen3 Swallow 8B 汎用・画像: Gemma 4 12B(12GB) 長文: Granite 4.2 8B |
| 16GB | Qwen3 Swallow 30B-A3B または Gemma 4 26B-A4B | 推論・汎用: Gemma 4 26B-A4B(引き続き本命) 日本語業務: LLM-jp-4.1 32B-A3B / Qwen3 Swallow 30B-A3B(CPUオフロード併用) |
| 24GB | Qwen3.6 27B / Qwen3 Swallow 32B / Gemma 4 31B | 汎用・マルチモーダル: Qwen3.8-27B(新しい本命) 日本語業務: LLM-jp-4.1 33B / Qwen3 Swallow 32B 超長文: Nemotron 3.5 Lightning |
| 32GB(RTX 5090 / Arc Pro B70) | ─ | 24GB帯のモデルを、長いコンテキストで余裕をもって動かせます。RTX 5090ならNemotron 3.5 LightningのNVFP4版も候補 |
| 128GB統合メモリ(Mac / Ryzen AI Max / DGX Spark) | (サーバー扱い) | 汎用: Qwen3.8-Flash-Next 日本語業務: GPT-OSS Swallow 120B |
| サーバー(H100 / H200級) | GLM-5.2等の巨大MoE | GLM-5.3-Flash(MIT)、DeepSeek V4.1-Flash(MIT)、Kimi K3。運用はvLLM / SGLang |
今回いちばん大きな変化は、24GB帯で「汎用ならQwen3.8-27B、日本語業務ならLLM-jp-4.1 33B」と、海外製・国産のどちらにもApache 2.0の有力候補がそろったことです。ライセンスが理由で選択肢が狭まる場面は、ほとんどなくなったと言ってよいと思います。
選ぶ前にやること: 自社タスクで小さく比較する
第74回でもお伝えしましたが、最終的な判断材料になるのは、公開ランキングよりも自社の実際の業務です。Ollamaなら、候補のモデルを並べて同じ質問を投げるだけで、最初の比較ができます。
# 候補モデルを取得(Hugging FaceのGGUFは hf.co/リポジトリ名:量子化 で直接取得できる)
ollama pull nemotron-3.5-lightning
ollama pull hf.co/<GGUFのリポジトリ名>:Q4_K_M

# 同じ業務プロンプトを各モデルに投げて、回答を保存する
for m in nemotron-3.5-lightning hf.co/<GGUFのリポジトリ名>:Q4_K_M; do
  ollama run "$m" "$(cat prompt_社内規程の要約.txt)" > "result_${m//[:\/]/_}.txt"
done評価用の質問は、実際の業務文書から20〜50問ほど用意すると判断しやすくなります(デジタル庁の「源内」でも、次の調達では評価の設問を50問から300問に増やす予定だと報じられています)。正解のある質問(規程の条文についての質問など)と、文章の自然さを見る質問(お客様向けメールの下書きなど)を混ぜるのがコツです。
国産LLMと制度の動き(8〜9月)
国産LLM各社
- NTT tsuzumi 2: Fsas TechnologiesとNTT西日本が、富士通のサーバー「PRIMERGY」上で動くオンプレミス版の提供を9月から始めると発表しました(8月26日)。重みは非公開ですが、「国産モデルを自社内に置く」という選択肢を、製品として購入できるようになりました
- NEC cotomi: AIエージェント製品「NEC cotomi Agent」を、Microsoft Marketplaceで発売しました(8月18日、1ユーザー月額15,000円)
- 富士通 Takane: 金融機関向けの専用AI基盤の開発を、8月から始めています
- PFN PLaMo: 主力のPLaMo 3.0 Primeは、APIでの提供が中心です。9月には金融に特化した小型モデルを公開しました(PLaMo Community License。商用利用には申請が必要です)
- SB Intuitions Sarashina3: 6月にクラウド経由での提供を始めています。8〜9月に新しいオープンウェイトの公開はありません
デジタル庁「源内」の国産LLM試用
第74回でご紹介した国産7モデルの試用は、当初の想定のように7モデルを一斉に試す形ではなく、段階的に進んでいます。5月には、5社(NTTデータ、ソフトバンク、NEC、富士通、PFN)と評価の契約を結んだと報じられました。7月には、tsuzumi 2・Takane 32B・PLaMo 2.0 Primeの3モデルをさくらインターネットのクラウド上で動かすことが発表されています。国産クラウド上に構築する、初めての政府事例です。9〜11月に既存モデルとのブラインド比較を行い、2027年1月に評価の一部を公表する予定です。なお、9月に比較が実際に始まったかどうかは、公式発表ではまだ確認できていません。
制度の動き
- 生成AI知財プリンシプル・コード(知的財産戦略本部、8月25日公表): 罰則のないソフトローで、「守るか、守らない場合は理由を説明する」という方式です。生成AIを国内向けに提供する事業者に、学習データの概要の公表や、権利者からの問い合わせへの対応を求めています。社内だけで使うローカルLLMには直接は及ばないと当社では考えています。ただし、自社のサービスとしてお客様に提供する場合は、対象になる可能性があります
- AI基本計画(第Ⅱ期)が7月14日に閣議決定されました。AI事業者ガイドラインは3月の第1.2版(AIエージェントに関する記載を追加)が最新で、8〜9月の改訂はありません
まとめ: 変わったこと、変わらないこと
変わらないこと
- 個人・小規模での主な選択肢は16〜24GB帯で、クラウドとローカルを併用するのが現実的であること
- Ollama(開発・少人数)/ vLLM(多人数の本番)/ LM Studio(検証)という役割分担
- 日本固有の知識が問われる業務では、日本語強化モデルや国産モデルも比較に入れたほうがよいこと
変わったこと
- 24GB帯の本命がQwen3.8-27Bに、国産の本命がLLM-jp-4 / 4.1になりました。どちらもApache 2.0です
- Nemotron 3.5 LightningとGranite 4.2の登場で、モデルカードに日本語サポートを明記した海外モデルが増えました
- 128GBの統合メモリ機が、「100B級のMoEを1台で動かす」ための現実的な手段になりました。ただ、GPUとメモリの価格高騰で、機材選びは以前より難しくなっています
- vLLMはModel Runner V2への移行期に入りました。本番で運用されている場合は、v0.32でのV1削除に備えておくと安心です
5月の第71回から5か月で、比較表の顔ぶれはほとんど入れ替わりました。それでも、選び方の基本は変わりません。ライセンスを確認し、VRAMに載るかを見積もり、自社の業務で試してみることです。モデルが新しいか古いかよりも、この3つを素早く回せる体制があるかどうかが、結果の差につながると私たちは考えています。ローカルLLMの導入や検証でお困りのことがあれば、どうぞお気軽にご相談ください。
参考資料(2026年10月1日時点で確認)
モデル(公式・モデルカード)
- Qwen/Qwen3.8-27B / Qwen/Qwen3.8-Flash-Next(Hugging Face)
- LLM-jp-4 33B 公開のお知らせ(2026年8月18日) / LLM-jp-4.1 公開(2026年9月28日) / LLM-jp-4-VL 9B
- NVIDIA Nemotron 3.5 Lightning 30B-A3B / NVIDIA Blog
- ibm-granite/granite-4.2-30b
- Introducing Gemma 4 12B(Google)
- Qwen3 Swallow / tokyotech-llm(Hugging Face)
- moonshotai/Kimi-K3 / deepseek-ai/DeepSeek-V4.1-Flash
ランタイム
- Ollama Releases(v0.33.0〜v0.35.0)
- llama.cpp PR #26185(Kimi K3対応) / PR #24162(DeepSeek V4対応)
- vLLM Releases(v0.28.0〜v0.30.0)
- LM Studio Changelog
- NVD: CVE-2026-7482
ハードウェア
- Apple: 新しいMac Studio(M5 Max / M5 Ultra)
- NVIDIA: DGX Spark 価格改定のお知らせ
- Tom's Hardware: AMD Ryzen AI Max 400(最大192GB)
- AKIBA PC Hotline!: メモリ価格の店頭調査(2026年9月)
評価・国内動向
- Nejumi Leaderboard / Qualiteg: LLMランキング分析(2026年9月1日)
- JamC-QA(LREC 2026)
- ITmedia: 源内、国産LLM 3モデルをさくらのクラウドで稼働(2026年7月10日)
- PR TIMES: tsuzumi 2 オンプレミス提供(2026年8月26日)
- NEC: NEC cotomi Agent 発売(2026年8月18日)
- 知的財産戦略本部(生成AI知財プリンシプル・コード)
本記事は2026年10月1日時点の公開情報に基づきます。VRAMの目安は当社による概算で、各モデルの性能を当社で実測したものではありません。ランキングの数値には第三者の分析記事によるものが含まれます。導入前には各公式情報と自社環境での検証をお願いします。