第83回ブログ|AIは「手元で動き、道具とつながり、見張られる」へ ─ Google開発者ブログ11本を初心者向けにやさしく解説
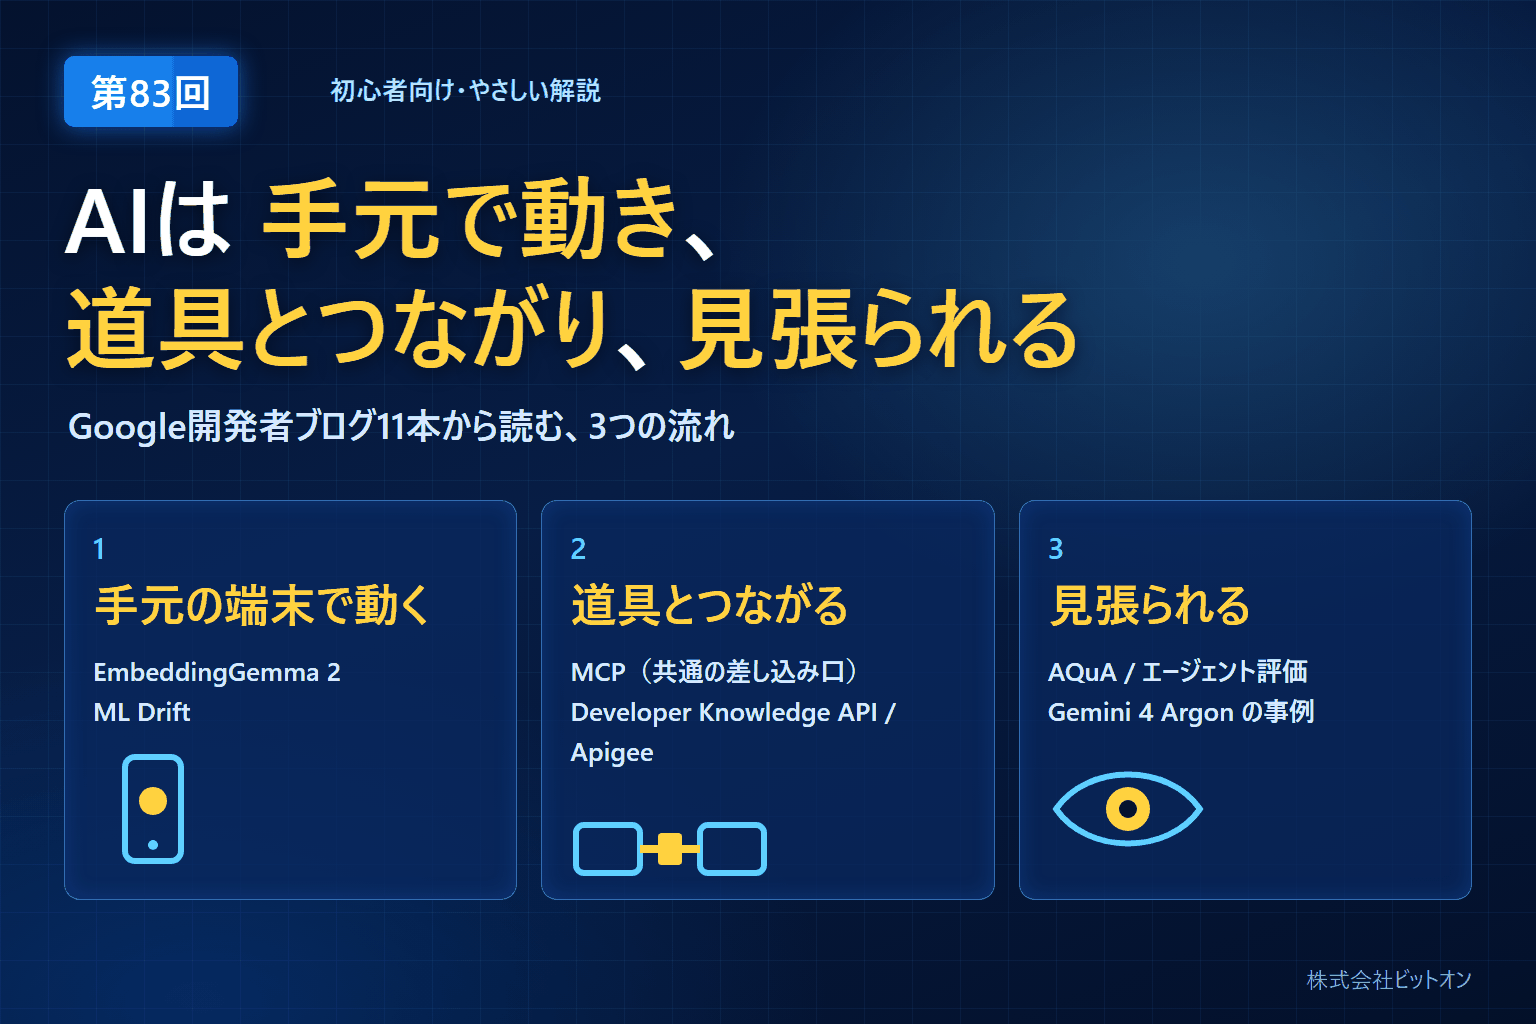
2026年9月末から10月中旬にかけて、Googleの開発者向けブログ(Google Developers Blog)に、AIに関する記事が続けて公開されました。一本ずつ読むと専門的で難しく感じますが、並べてみると、大きく3つの流れに分けられます。
- AIを小さくして、手元の端末で動かす
- AIと道具をつなぐ「差し込み口」の形がそろってきた
- AIに任せる仕事が増え、それを見張る道具も出てきた
今回は、この3つの流れに沿って、計11本の記事の中身をできるだけやさしくご紹介します。内容は各記事と公式ドキュメントに書かれていることだけに絞りました。数値はすべてGoogleの発表で、当社では計測していません。
1. AIを小さくして、手元の端末で動かす
これまで、高性能なAIを使うには、データをインターネット越しに大きな計算機(クラウドのサーバー)へ送って処理してもらうのが一般的でした。これに対して、スマートフォンやパソコンなど手元の端末の中だけでAIを動かすやり方を「オンデバイスAI」や「エッジAI」と呼びます。端末の中で処理が終われば、写真や音声などのデータを外に送らずに済みます。
この流れに関係する記事が3本ありました。
EmbeddingGemma 2:文章・画像・動画・音声を「同じ地図」に置く小型AI
記事:「Bring multimodal semantic search to the edge with EmbeddingGemma 2」「EmbeddingGemma 2: The Developer Guide」(いずれも2026年10月6日)
2026年10月6日、Google DeepMindはEmbeddingGemma 2を公開しました。これは「埋め込み(エンベディング)」を作るためのAIです。
- 埋め込み(エンベディング)
- 文章や画像の「意味」を、数字の並び(ベクトル)に置き換えたものです。EmbeddingGemma 2の場合は768個の数字の並びになります。意味が近いものほど、数字の並びも近くなるように作られています。地図にたとえると、意味の近いものが近い場所に置かれる「意味の地図」のようなものです。
- 意味検索(セマンティック検索)
- 言葉が一字一句一致しなくても、意味が近いものを探す検索です。埋め込み同士の「近さ」を計算して探します。
- パラメータ
- AIの中にある調整用の数値の数で、AIの大きさの目安です。数が多いほど一般に高性能ですが、必要なメモリも増えます。
EmbeddingGemma 2の特長は、文章・プログラムのコード・画像・動画・音声を、すべて同じ「意味の地図」(768次元の共通の空間)に置ける点です。同じ地図の上に並ぶので、たとえば「海辺の夕焼け」という文章で検索して、スマートフォンの中の写真や動画を直接探す、といったことができます。
大きさは全部入りで7億4,000万パラメータで、文章用の土台(2億7,000万)に、画像用(1億7,000万)と音声用(3億)の部品を足した作りです。必要な部品だけを読み込めるようになっています。
| 組み合わせ | パラメータ数 |
|---|---|
| 文章・コードのみ | 2億7,000万(270M) |
| 文章 + 画像 | 4億4,000万(440M) |
| 文章 + 音声 | 5億7,000万(570M) |
| すべて | 7億4,000万(740M) |
記事に書かれている主な事実は次のとおりです。
- オープンなモデルです。ライセンスはApache 2.0で、Gemma 4をもとに作られています。Hugging Faceなどからダウンロードでき、Ollama、LM Studio、sentence-transformersといった既存の道具でも使えます
- スマートフォンで使うメモリは、Google Pixel 11 Proで、文章だけなら約191MB、全部入りで約567MBと発表されています
- 一度に扱える長さは8,192トークン(AIが文章を読むときの単位)で、公式ドキュメントでは100以上の言語に対応するとされています
- 数字の並びを768個から512・256・128個に短くして保存容量を減らすこともできます。開発者ガイドによると、100万件を保存する場合、768個で約1.5GB、128個で約250MB(約6分の1)です。ただし128個まで縮めると、文章は約90%、画像・動画・音声は約75%まで精度が下がるとされ、自分のデータで確かめるよう書かれています
- 前の世代(EmbeddingGemma 1)と比べて、プログラムのコード検索の性能が上がっています(Hugging Faceのモデルページでは、コード検索の指標が68.76から78.68に向上)
- 試せるアプリとして、スマートフォン用の「Google AI Edge Gallery」に、端末の中の写真や動画を言葉で探す機能などが入っています
※Hugging Faceのモデルページには、このモデルには安全面の調整(不適切な出力を抑える調整)は施されておらず、対策は開発者の責任で行うよう記載があります。
ML Drift:機種ごとに違うGPUの差を吸収する土台
記事:「ML Drift: Next-Gen GPU AI/ML Inference at the Edge」(2026年10月8日)
AIを端末で速く動かすには、画像処理用の半導体であるGPUを使うのが効果的です。ところが、GPUを動かすための仕組みは、Android、iPhone、パソコン、Webブラウザで別々です(OpenGL ES、OpenCL、Metal、WebGPUなど)。機種ごとに作り分けるのは大変な手間です。
ML Driftは、こうした違いを吸収して、同じAIをさまざまな端末のGPUで動かせるようにする土台です。オープンソース(Apache 2.0)で公開されています。
- Googleの端末向けAI実行基盤「LiteRT」の中で、GPUを使う部分の中心になっています。旧来の「TFLite GPU delegate」の後継で、既存のモデルとの互換性も保たれています
- 対応する環境はAndroid、iOS、Webブラウザ(WebGPU)です。Windows・Linux・macOSのパソコン向けは「プレビュー(試験提供)」とされています
- すでにGoogleの製品で使われていて、記事では次のような効果が紹介されています
| 使われている製品 | 発表されている効果 |
|---|---|
| YouTube ショート | Android・iOSで、1コマあたりの平均処理時間が最大40%短縮 |
| Google フォト | 旧来の仕組みより最大2秒速い |
| Adobe Lightroom・Photoshop(被写体の選択など) | スマートフォンで最大30%高速化 |
| Snap(カメラのエフェクト) | AIの処理時間が30%短縮 |
記事では、ChromeやGoogle Meetなどでも使われ、毎日数百万台の端末で動いていると説明されています。
TPUで動画生成の計算を間引く(こちらはデータセンター側の話)
記事:「Accelerating Spatio-Temporal Attention for Video Diffusion on TPUs」(2026年9月30日)
3本目は、手元の端末ではなく、Googleのデータセンター側の話です。TPUは、GoogleがAIの計算専用に自社で作っている半導体です。
AIで動画を作るときは、膨大な計算が必要です。その中でも「アテンション」と呼ばれる、動画の中のあらゆる部分同士の関係を調べる計算が、時間の大半を占めます。記事によると、TPU v6eを8枚使って81コマの動画を作る場合、この計算が占める割合は720pで55.5%、1440pでは88.2%に達していました。
そこで、既存の研究(Sparse VideoGen)の考え方を使い、「同じコマの中の関係を見る部分」と「時間方向の関係を見る部分」に分けて、関係の薄い組み合わせの計算を省くことで、全体を速くしました。ただし、単に計算を省くだけでは逆に遅くなる場合があり、TPUの計算の単位に合わせて省き方を工夫したことが、記事の中心になっています。
| 動画の解像度 | 省かない場合 | 省いた場合 | 速さ |
|---|---|---|---|
| 720p | 153.50秒 | 119.86秒 | 1.28倍 |
| 1080p | 683秒 | 457秒 | 1.49倍 |
| 1440p | 2,471秒 | 1,461秒 | 1.69倍 |
※TPU v6e 8枚、81コマの動画での計測です(Googleの発表)。1440pでは1本あたり16分以上の短縮になります。画質は、省かない場合の動画との比較で示されていますが、記事ではどの動画生成AIで試したのかは明らかにされていません。
場所は手元とデータセンターで違いますが、「計算を減らしてAIを軽くする」という狙いは、前の2本と共通しています。
2. AIと道具をつなぐ「差し込み口」の形がそろってきた
AIに実際の仕事をさせるには、AIを資料やデータベース、社内のシステムなどの「道具」につなぐ必要があります。ところが、つなぎ方がAIや道具ごとにばらばらだと、組み合わせを変えるたびに作り直しになってしまいます。
そこで広まりつつあるのが、MCP(Model Context Protocol)という共通の決まりです。
- MCP(エムシーピー)
- AIアプリを外部のシステムにつなぐための、オープンソースの共通規格です。2024年11月にAnthropic社が公開しました。公式サイトでは「AIアプリのためのUSB-Cポートのようなもの」と説明されています。差し込み口の形がそろっていれば、どのAIからでも同じ道具を使えます。
- API(エーピーアイ)
- プログラム同士がやりとりするための窓口です。
Developer Knowledge API:AIがGoogleの公式説明書を最新の状態で読める
記事:「Supercharge your development with the Google Developer Knowledge API ecosystem」(2026年10月7日)
AIにプログラムを書いてもらうと、古い情報をもとに、もう使えない書き方を答えてしまうことがあります。AIが学習した時点の知識しか持っていないためです。
Developer Knowledge APIは、Google Cloud、Firebase、AndroidなどのGoogleの公式の開発者向けドキュメントを、AIやプログラムから検索・取得できる窓口です。記事では「頻繁に索引が更新される」とされ、公式ドキュメントでは、公開から48時間以内に索引に反映することを目標にしていると書かれています。
- MCPサーバーが用意されていて、Google Antigravity、Claude Code、Cursor、GitHub CopilotなどのAI開発ツールからつなげます
- コマンドライン(
gcloud)から、質問して答えを得ることもできます(例:gcloud developer-knowledge answer-query --query="How do I create a BigQuery dataset?") - C#、Go、Java、Node.js、PHP、Python、Rubyのライブラリも用意されています
- 公式ドキュメントによると、対象は公開されているGoogleのドキュメントのみで、現時点では英語のみです
※記事・公式ドキュメントのいずれにも、料金や「プレビュー版/正式版」の区分は明記されていませんでした(2026年10月20日時点)。
Apigee hybrid のMCP対応:AIの通信を自社の設備の中にとどめる
記事:「Announcing MCP support in Apigee hybrid: agentic tools that run in your own cluster」(2026年10月14日)
Apigee(アピジー)は、企業が自社のAPIを公開・管理するためのGoogle Cloudのサービスです。「hybrid」は、その実際の処理を担う部分を、自社で管理するサーバー群(Kubernetesクラスター)の中で動かす形態です。
2026年9月14日公開のApigee hybrid 1.17.0で、このhybrid形態でもMCPが使えるようになったことが発表されました。
- APIの仕様書(OpenAPI 3.0)を渡すと、その中の操作の一つひとつがAIから使える「道具」になります。MCPサーバーのプログラムを自分で書く必要はありません
- 記事によると、AIとのやりとり(MCPの通信)は自社のクラスターの中だけで完結し、Google Cloudへは出ていきません。設定はクラスター側から取りに行く方式なので、Googleから社内ネットワークへの接続を受け入れる必要もありません
- どのAIにどの道具を見せるかを細かく決められます。記事では「見せてもらっていない道具は、そもそも呼び出せない」と説明されています
- この機能は初期状態ではオフで、使う場合は設定で有効にします
社外にデータを出したくない、という事情はAIの活用で特に気になる点です。1章の「手元で動かす」と同じく、データを外に出さない方向の話題といえます。
3. AIに任せる仕事が増え、見張る道具も出てきた
最近は、人が一つずつ指示しなくても、自分で手順を考えて作業を進めるAIが増えています。これをAIエージェントと呼びます。Googleの記事からは、エージェントが試作の段階から、実際の業務で動かす段階に移りつつあることがうかがえます。
- AIエージェント
- 目的を与えると、必要な道具を自分で選んで使い、手順を組み立てて作業するAIです。
- ADK(Agent Development Kit)
- Googleが公開している、AIエージェントを作るためのオープンソースの開発キットです。Python、TypeScript、Go、Java、Kotlinに対応しています。
- トレース
- AIが「いつ・何を考え・どの道具を・どう使ったか」を記録した作業記録です。
AQuA:本番で動くAIの「黙った失敗」を見つける
記事:「The Outer Loop, Insights First: An Ambient Quality Agent That Diagnoses Your Production Agent」(2026年10月8日)
AIエージェントの困ったところは、間違った答えでも、見た目は正常に返ってくることです。記事では、旅行予約のエージェントが、座席の担当に確認しないまま「座席3Aを確保しました」と答えてしまう例が挙げられています。エラーも出ず、応答も速いので、従来の監視の仕組みでは気づけません。
そこでGoogleが公開したのが、AQuA(Ambient Quality Agent)です。本番で動いているエージェントの「横」で、その作業記録(トレース)を読んで品質を確かめるエージェントです。
- 最近のやりとりから、最大1,000件を無作為に選ぶ
- 9項目のチェックリスト(手順を守ったか、道具の選び方は正しいか、根拠のある答えか、など)で採点する
- 同じ原因で起きている失敗をまとめる
- 別のAIが、本当にその失敗が起きているかを確かめ、根拠のないものを除く
- 前回までの結果と照らし合わせ、新しい問題か、くり返し起きている問題かを記録する
- 利用者の自社のGoogle Cloudの中で動き、本番のエージェントの処理の流れには入りません。エージェントを書き換えることもしません
- 原因がプログラムにある場合は、該当するファイルと行を示して修正案を出します。ただし、修正の適用は人が行います
- 記事の例では、32件のやりとりを調べて6つの問題を見つけ、2つを1行ずつの修正で直しました。その結果、座席の確認漏れは15件から2件に、「ビーガン(菜食)」の条件が抜け落ちる問題は7件から0件に減り、すべて正しく終えたやりとりは32件中5件から13件に増えています。このときの調査費用は3.76ドルでした
- 記事は限界にも触れています。無作為に選ぶため、ごく一部(たとえば1%)でしか起きない問題は見つけにくいことなどです
評価は「なんとなく」から卒業する
記事:「Evaluating AI agents: moving past the vibe check」(2026年10月15日)
こちらは、エージェントを作る段階での「評価のしかた」を解説した記事です。よくあるのは、3〜4回試しに話しかけて、良さそうなら完成とする方法です。記事ではこれを「vibe check(なんとなくの確認)」と呼び、次のような進め方を勧めています。
- 「誰が、何のために、どんな条件で使うか」を具体的に書き出し、その一つひとつを確認項目にする
- 採点は「1〜5点」のようなあいまいな基準ではなく、「返金の前に顧客IDを確認したか(はい/いいえ)」のようなはい・いいえで答えられる基準にする
- テスト用のデータは固定し、一度に変えるのは1か所だけにする
- 正解かどうかだけでなく、かかった時間・費用・道具の呼び出し回数も記録する
- 最初の5〜20件の作業記録は、人が実際に読む
記事は「どんなに簡単なものでも、くり返し使える評価の仕組みがあるほうが、思いつきの確認よりよい」としています。評価用の道具「agent-eval」もオープンソースで紹介されています。
adk-recipes:エージェントを作るための部品集
記事:「Three layers, one repo: a tour of google/adk-recipes」(2026年10月15日)
同じ日に、ADKを使ったエージェントの見本と部品をまとめたgoogle/adk-recipesの紹介記事も出ました。これまでの見本集(adk-samples)を整理し直した後継です。基本の型(core/)、組み込める部品(plugins/、最初は小売業向け)、そのまま動かせる完成例(contrib/)の3層に分かれています。先ほどのAQuAも、この中に入っています。
※リポジトリには「Googleの正式なサポート対象製品ではなく、本番利用ではなく出発点・見本として使うもの」と明記されています。
20万行のプログラムを、AIが一晩かけて改善した報告
記事:「Optimizing a 200,000-line Python codebase overnight with Gemini 4 Argon」(2026年10月13日)
2026年10月13日、Googleは新しいAI「Gemini 4 Argon」を公開しました。Gemini 4シリーズの最初のモデルです。これに合わせて、Argonに大きなプログラムを改善させた報告が公開されました。
対象は、ADKのPython版そのもの(約20万5,000行、約800ファイル、約1万7,000件のテスト)です。「どんなエージェントにも、目立った処理の遅れを生まないようにする」という目標を与え、夜9時11分から11時間、Argonに作業させました。
- 1回目は、目標を1段落で伝えただけでした。公開済みの仕様を勝手に変える、テストを一部しか実行しない、といった問題が出ました
- 2回目は、開発のルールをまとめたファイルを用意し、目標を忘れないようにする機能(Google Antigravityの「/goal」モード)を使いました
- Argonは6つの改善案を出しましたが、採用されたのは2つで、4つは見送られました。見送られた案には、「速くはなるが、別のやりとりの古いデータを返してしまうおそれがある」ものも含まれていました
- 最終的な変更(22ファイル、新しいテスト17件)は、開発者の確認を経て取り込まれました
- 効果は、長いやりとりでの事前処理の時間が約40%短縮、読み込みが21%高速化、158回のやりとりで65.6秒から56.1秒への短縮です。ただし約40%の効果は、特定の保存方式(メモリ上に保存する方式)を使った場合に限られます
記事は教訓を「エージェントが探り、メンテナー(開発の責任者)が削る」とまとめています。AIが一人で完成させたというより、AIがたくさん試し、人が選んで仕上げたという報告です。
現実の機械(ロボット)を扱うAI
記事:「Gemini 4 Argon for Robotics」(2026年10月13日)
同じGemini 4 Argonを、ロボットに使う発表もありました。記事では、ものの位置や動きといった物理的な世界を理解する力が大きく伸びたと説明されています。ロボット向けの推論力を測る試験(ERQA)では87%を記録し、記事では他の最先端のAIを上回ったとしています(比較相手の名前や点数は示されていません)。
- Boston Dynamicsの四足ロボット「Spot」に、足踏み式のごみ箱のペダルを踏ませて、空き缶を捨てさせました。Argonはまず、ごみ箱を再現したシミュレーション(仮想空間)を作り、そこで練習しています
- 写真1枚から仮想空間に作業場を再現し、そこで4,500回以上の練習データを集めてロボットを学習させた例では、現実の作業の成功率が56%から75%に上がり、作業時間は35秒から24秒に縮みました
※記事に載っている多くは実演(デモ)で、成功率などの数値が示されていないものもあります。
まとめ
| 流れ | 主な発表 | ひとことで言うと |
|---|---|---|
| 手元で動かす | EmbeddingGemma 2、ML Drift(+TPUの動画生成高速化) | 小さく・軽くして、データを外に出さずにAIを使う |
| 道具とつなぐ | Developer Knowledge API、Apigee hybridのMCP対応 | 共通規格MCPで、最新の資料や社内の道具にAIをつなぐ |
| 見張る・任せる | AQuA、評価の手引き、adk-recipes、Gemini 4 Argonの事例 | 任せる仕事が増えたぶん、品質を確かめる仕組みも整えていく |
3つの流れは別々の話に見えますが、「AIを実際の仕事で安心して使えるようにする」という方向は共通していると私たちは考えています。データを外に出さないこと、正しい情報や道具に安全につなぐこと、そして結果をきちんと確かめること。どれも、企業でAIを使ううえで避けて通れないテーマです。
特に、Argonの事例で6つの案のうち4つが見送られたことや、AQuAが修正を人に任せていることからは、AIに任せる範囲が広がっても、最後に判断するのは人だという姿勢が読み取れます。
社内でのAI活用や、データを外に出さないAIの使い方、AIエージェントの導入などでお困りのことがあれば、どうぞお気軽にご相談ください。
参考資料(2026年10月20日時点で確認)
Google Developers Blog(developers.googleblog.com)の記事
- Bring multimodal semantic search to the edge with EmbeddingGemma 2(2026年10月6日)
- EmbeddingGemma 2: The Developer Guide(2026年10月6日)
- ML Drift: Next-Gen GPU AI/ML Inference at the Edge(2026年10月8日)
- Accelerating Spatio-Temporal Attention for Video Diffusion on TPUs(2026年9月30日)
- Supercharge your development with the Google Developer Knowledge API ecosystem(2026年10月7日)
- Announcing MCP support in Apigee hybrid: agentic tools that run in your own cluster(2026年10月14日)
- The Outer Loop, Insights First: An Ambient Quality Agent That Diagnoses Your Production Agent(2026年10月8日)
- Evaluating AI agents: moving past the vibe check(2026年10月15日)
- Three layers, one repo: a tour of google/adk-recipes(2026年10月15日)
- Optimizing a 200,000-line Python codebase overnight with Gemini 4 Argon(2026年10月13日)
- Gemini 4 Argon for Robotics(2026年10月13日)
公式ドキュメントなど
- EmbeddingGemma(Google AI for Developers)
- google/embeddinggemma-2(Hugging Face)
- ML Drift(GitHub)
- Connect to the Developer Knowledge MCP server
- MCP in Apigee(Google Cloud ドキュメント)
- google/adk-recipes(GitHub)
- Agent Development Kit(ADK)
- Gemini 4 Argon: Built to solve your hardest problems(Google、2026年10月13日)
- Model Context Protocol 公式サイト
- Introducing the Model Context Protocol(Anthropic、2024年11月25日)
本記事は2026年10月20日時点の公開情報に基づきます。性能・メモリ・時間・費用などの数値はすべてGoogleなど各社の発表によるもので、当社で計測したものではありません。導入を検討される際は、公式情報と自社環境での検証をお願いします。